Apa Itu Jev dari TypeSafe AI? Model Keputusan Terstruktur untuk Developer
23 September 2026 · 7 menit baca
Artikel ini dibuat secara otomatis dengan bantuan AI dan telah ditinjau oleh Arya Anjar Ginantara.
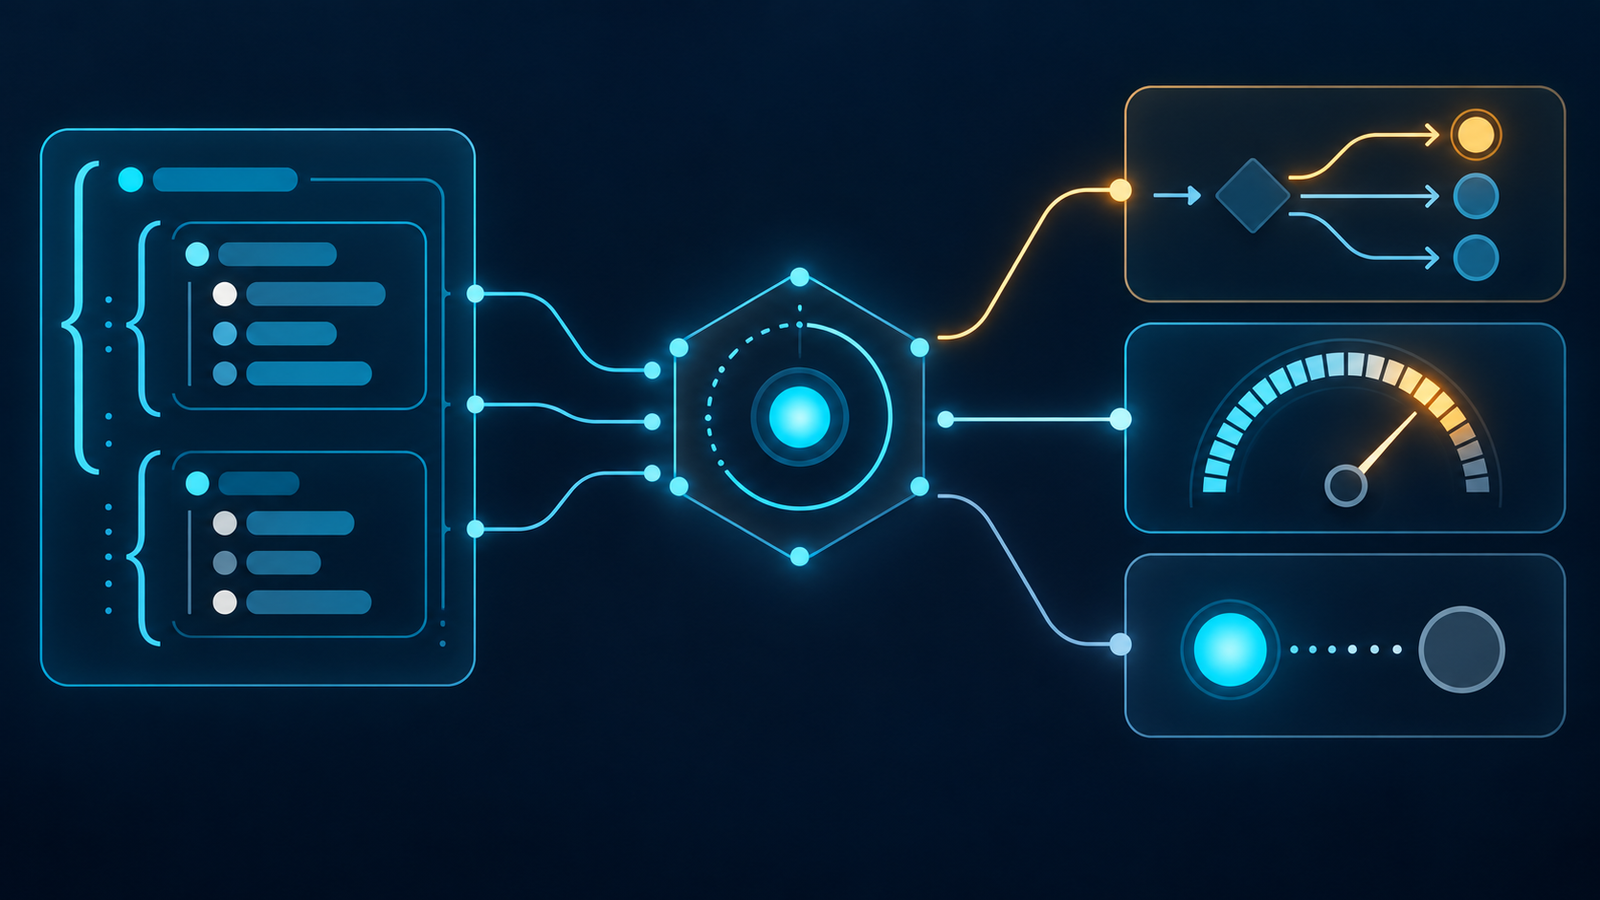
Jev dari TypeSafe AI bukan chatbot untuk percakapan atau jawaban panjang. Ia juga bukan alat untuk menulis kode. Jev lebih tepat dipahami sebagai lapisan keputusan bertipe di antara data aplikasi dan logika program.
Bayangkan sebuah tiket dukungan pelanggan berbunyi, “Tagihan saya terpotong dua kali dan belum kembali.” Aplikasi perlu menjawab tiga pertanyaan: tiket ini masuk kategori apa, seberapa tinggi prioritasnya, dan apakah kasusnya perlu diperiksa manusia? Untuk alur seperti ini, aplikasi tidak membutuhkan paragraf jawaban. Aplikasi membutuhkan keputusan terstruktur yang dapat dibaca kode secara konsisten.
Dalam Jev, konteks yang hendak dinilai disusun sebagai state. Developer kemudian mengajukan typed questions yang bentuk jawabannya sudah ditentukan, lalu menerima results yang dapat dipakai oleh logika aplikasi:
state -> typed question -> typed result -> application code
state dapat berisi teks tiket dan metadata yang memang boleh diproses. Results dapat berupa pilihan, skor, probabilitas, atau nilai 0–1, bukan paragraf yang harus ditafsirkan ulang. Dokumentasi pengantar TypeSafe menjelaskan kontrak ini sebagai evaluasi typed questions terhadap sebuah state dengan hasil terstruktur.
Bentuk output yang valid secara struktur belum tentu berarti keputusannya benar. Type safety membantu membatasi bentuk hasil, tetapi tidak menjamin semantic correctness. Karena itu, kode aplikasi tetap perlu menentukan threshold, fallback, jalur review manusia, dan tindakan yang boleh dijalankan.
Contoh nyata: keputusan Jev dalam demo Doom
The Register melaporkan demonstrasi Doom dari TypeSafe. Dalam demonstrasi itu, Jev menerima state terstruktur yang menggambarkan kondisi permainan. Alih-alih menulis narasi tentang apa yang terjadi, model mengembalikan keputusan bertipe beserta probabilitas agar kode dapat menentukan langkah berikutnya.
Doom berguna sebagai ilustrasi karena kondisi permainan terus berubah, sementara software membutuhkan keputusan yang ringkas dan dapat segera dipakai. Pola ini memperlihatkan batas kerja Jev dengan cukup jelas: state masuk, pertanyaan dibatasi, lalu probabilitas keluar. Namun, demonstrasi yang dilaporkan tersebut bukan benchmark independen. Ia tidak membuktikan bahwa Jev selalu unggul pada setiap tugas atau sudah siap untuk semua lingkungan produksi.
Video TheoLeeCJ tentang reproduksi open-source yang terinspirasi Jev memperlihatkan eksperimen langsung dengan pola antarmuka serupa dan Doom. Reproduksi itu membantu menjelaskan ide arsitekturnya, tetapi bukan pengujian terhadap layanan Jev milik TypeSafe. Hasil dari proyek reproduksi juga tidak dapat dipakai sebagai hasil produk asli.
Untuk alur bisnis, tiket dukungan pelanggan pada pembukaan artikel lebih dekat dengan kebutuhan sehari-hari. Isi tiket dan metadata menjadi state; pertanyaan terbatas dapat memilih kategori, menilai prioritas, atau memperkirakan apakah kasus perlu ditinjau manusia. Model memberi sinyal terstruktur, sedangkan kode tetap memegang threshold, fallback, pencatatan, dan tindakan berikutnya. Artikel ini tidak menjalankan API atau SDK Jev, sehingga contoh bisnis tersebut tetap merupakan analogi penerapan, bukan hasil pengujian produk.
Choice, Score, dan Noul: tiga bentuk pertanyaan Jev
Jev mendokumentasikan tiga primitive. Ketiganya dapat dipakai dalam satu permintaan dan dievaluasi terhadap state yang sama, tetapi masing-masing menjawab jenis pertanyaan yang berbeda.
Choice memilih satu opsi yang diizinkan
Choice digunakan ketika daftar hasil sudah diketahui. Untuk routing tiket, opsinya dapat berupa kategori dukungan yang telah didefinisikan tim. Hasil yang didokumentasikan mencakup opsi terpilih, distribusi probabilitas, dan confidence.
Batas schema mencegah model mengarang kategori di luar daftar, tetapi tidak menjamin kategori terpilih benar. Daftar yang buruk juga dapat memaksa kasus yang sebenarnya tidak cocok masuk ke salah satu opsi. Karena itu, opsi seperti needs_review berguna bila proses memang menyediakan jalur manual.
Score menilai pada skala yang ditentukan
Score menghasilkan nilai pada skala yang ditetapkan dalam pertanyaan, beserta probabilitas dan confidence yang didokumentasikan. Bentuk ini dapat dipakai untuk penilaian seperti tingkat prioritas yang definisinya sudah dibuat jelas oleh tim.
Angka tetap merupakan hasil penilaian model, bukan pengukuran objektif hanya karena tampil presisi. Arti setiap rentang, threshold tindakan, dan penanganan kasus di dekat batas harus ditentukan serta diuji pada workflow setempat.
Noul menyatakan probabilitas jawaban “ya”
Noul adalah pertanyaan biner yang mengembalikan nilai 0–1: probabilitas bahwa jawaban atas pertanyaan tersebut adalah “ya”. Nilai mendekati 1 mengarah ke “ya”, sedangkan nilai mendekati 0 mengarah ke “tidak”. Ia bukan label bebas dan bukan confidence milik Choice atau Score.
Pertanyaan Noul perlu dirumuskan secara spesifik. “Apakah tiket ini berisiko?” terlalu kabur bila tim belum mendefinisikan risiko yang dimaksud. Probabilitas yang keluar juga belum membuktikan bahwa model terkalibrasi untuk data, bahasa, dan konsekuensi bisnis Anda.
Di mana Jev berbeda dari kode dan LLM generatif?
Jev bukan pengganti semua logika software. Ia berada di antara dua pendekatan yang sudah umum: aturan deterministik dan model generatif.
Kode deterministik paling tepat ketika jawabannya dapat dihitung atau dipastikan melalui aturan eksplisit. Total transaksi, perbandingan tanggal, validasi format, batas kebijakan, dan izin tindakan sebaiknya tetap dikendalikan kode. Halaman keterbatasan Jev sendiri menyarankan penggunaan kode untuk matematika, counting, serta perbandingan tanggal dan waktu.
LLM generatif lebih sesuai ketika aplikasi membutuhkan bahasa, kode, ringkasan, rencana, atau penjelasan terbuka. Sebagian LLM generatif juga digunakan dengan structured output agar respons mengikuti schema. Pada level integrasi, hasilnya dapat sama-sama mudah diproses program. Perbedaan yang penting bukan sekadar “JSON versus teks”: kontrak produk Jev sejak awal berpusat pada pertanyaan bertipe dan keputusan probabilistik yang terbatas, sedangkan model generatif tetap dirancang untuk menghasilkan respons dan dapat dibatasi ke sebuah struktur saat workflow memerlukannya.
Keduanya berbagi batas yang sama penting: struktur valid tidak menjamin makna benar. LLM dengan structured output dapat mengisi field yang keliru; Jev dapat memilih opsi yang diizinkan tetapi salah. Refix menyoroti risiko wrong in-schema decision, sementara The Register mengingatkan bahwa keluaran terstruktur tetap dapat tidak benar.
Pembagian perannya dapat diringkas seperti ini:
| Masalah | Pilihan awal yang masuk akal |
|---|---|
| Rumus, counting, tanggal, aturan kebijakan eksplisit | Kode deterministik |
| Prosa, kode, ringkasan, atau penjelasan terbuka | LLM generatif, dengan verifikasi |
| Keputusan sempit dengan opsi atau skala yang sudah diketahui | Jev layak dievaluasi |
| Keputusan sempit yang juga memerlukan alasan panjang untuk pengguna | Pisahkan keputusan dan penjelasan; uji setiap komponen |
Type safety bukan semantic correctness
Istilah “type safe” mudah disalahartikan sebagai “pasti benar”. Dalam konteks interface Jev, type safety membatasi bentuk hasil: sebuah Choice harus kembali sebagai salah satu opsi yang tersedia, misalnya. Jaminan bentuk itu berguna karena aplikasi tidak perlu menangani jawaban bebas yang tak terduga.
Namun, model masih dapat memilih billing untuk kasus yang seharusnya masuk account. State dapat tidak lengkap, label dapat tumpang tindih, pertanyaan dapat ambigu, atau distribusi data dapat berubah. Dengan kata lain, valid menurut schema tidak sama dengan benar secara semantik.
Karena alasan itu, klaim pemasaran “zero hallucinations” tidak boleh dibaca sebagai jaminan bahwa Jev selalu mengambil keputusan benar. Pernyataan yang lebih tepat adalah: interface bertipe dapat mencegah hasil di luar bentuk yang diizinkan, tetapi tidak mencegah keputusan salah di dalam bentuk tersebut. Confidence dan probabilitas pun merupakan sinyal untuk dievaluasi, bukan izin otomatis bagi tindakan yang sulit dibatalkan.
Aturan keputusan praktis
Minat dan hype terhadap Jev datang dari batas software yang berbeda. Model khusus seperti ini dapat mengembalikan keputusan terbatas dan probabilitas yang langsung dibaca kode. Dalam kasus yang cocok, aplikasi mungkin tidak perlu meminta LLM umum menulis prosa terlebih dahulu, lalu menafsirkan kembali prosa itu menjadi keputusan.
Itu tidak menjadikan Jev pengganti LLM umum. LLM generatif tetap lebih cocok untuk bahasa, penalaran terbuka, kode, ringkasan, dan penjelasan. Salah satu kemungkinan untuk sistem mendatang adalah menggabungkan LLM generatif pada bagian bahasa atau penalaran dengan model berorientasi keputusan untuk routing, verifikasi, scoring, dan guardrail. Ini adalah interpretasi atas pembagian peran teknologinya, bukan hasil industri yang sudah terbukti atau prediksi bahwa pola tersebut pasti menjadi standar.
Bukti produk juga masih terbatas. Belum ada benchmark Jev independen dalam sumber artikel ini, dan artikel ini tidak menjalankan API atau SDK, menguji akurasi bahasa Indonesia, atau mengukur latency dari Indonesia. Pernyataan vendor bahwa input tidak dipakai untuk melatih model juga tidak dengan sendirinya membuktikan zero retention atau ZDR untuk setiap plan. Versi model, akses, harga, limit, dan ketentuan privasi dapat berubah, jadi detail tersebut perlu diperiksa kembali sebelum keputusan penggunaan.
Aturan akhirnya sederhana: gunakan kode deterministik ketika aturan dapat ditulis dan diverifikasi secara eksplisit; gunakan LLM generatif ketika hasilnya perlu berupa bahasa, kode, rencana, atau penjelasan terbuka; evaluasi Jev ketika aplikasi membutuhkan keputusan sempit dengan bentuk hasil yang sudah diketahui, lalu uji semantic correctness pada data lokal dan pertahankan fallback untuk kasus yang meragukan.